Walk-forward-Validierung: die Zukunft aus dem Training heraushalten
Entwerfen Sie einen chronologischen Forschungsprozess, der das gesamte Entscheidungsverfahren bewertet statt einer optimierten historischen Regel.
Einen Prozess testen statt einer endgültigen Formel
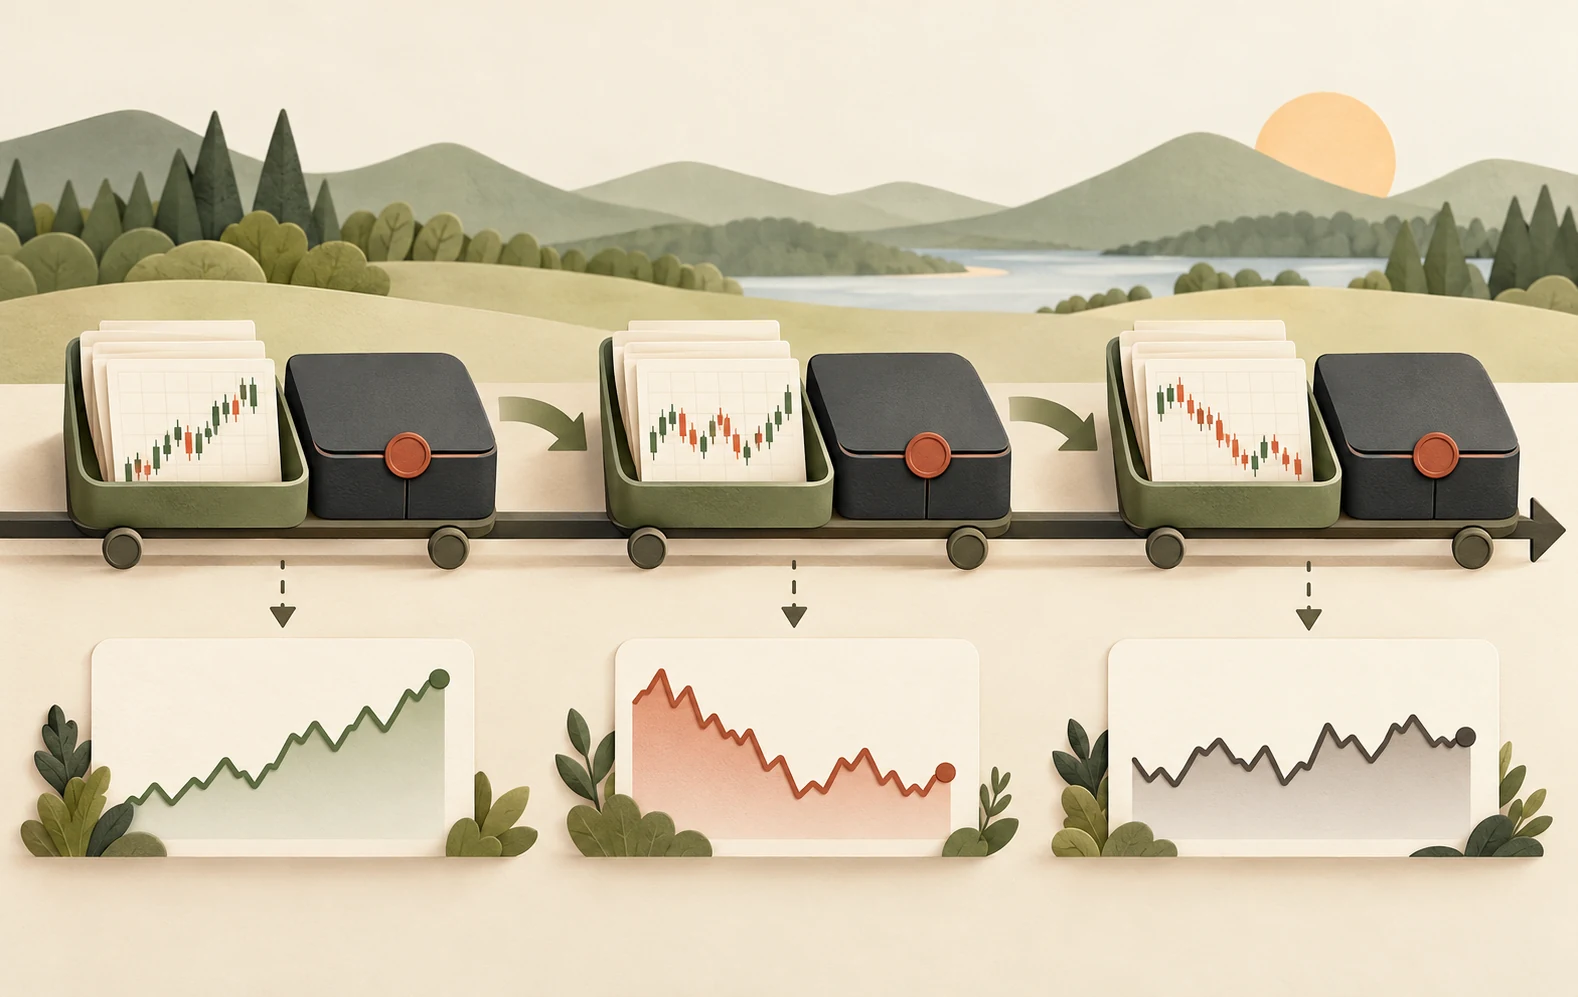
Eine Walk-forward-Studie passt wiederholt ein Modell mit an einem historischen Datum verfügbaren Informationen an, friert Entscheidungen ein und bewertet sie später. Dann schreitet die Abfolge voran. Das ahmt einen Prozess ohne Zukunftswissen nach. Es macht weder eine Strategie profitabel noch beseitigt es jede Verzerrung.
Schreiben Sie auf, was sich in jedem Schritt ändern darf. Signalparameter, Anlageauswahl, Volatilitätsschätzungen und Kostenannahmen gehören alle zum Verfahren. Passt der Forscher sie nach Betrachtung einer Testperiode manuell an, wurde das Verfahren geändert und die Periode ist keine unverfälschte Bewertung mehr. Ein reproduzierbarer Zeitplan ist informativer als ein aus Ermessensänderungen zusammengesetzter Chart.
Bewusst zwischen rollierender und wachsender Historie wählen
Ein wachsendes Fenster behält mit fortschreitender Zeit alle früheren Beobachtungen. Dies kann Schätzungen stabilisieren, aber auch Daten aus überholten Marktbedingungen bewahren. Ein rollierendes Fenster nutzt einen festen jüngsten Zeitraum, erleichtert Anpassung und erhöht zugleich das Stichprobenrauschen. Kein Ansatz ist allgemein überlegen; der relevante Zielkonflikt hängt davon ab, welcher wirtschaftliche Zusammenhang als beständig angesehen wird.
Wählen Sie Fensterlängen aus einem belastbaren Grund vor Ergebnisvergleichen. Dutzende Längen auszuprobieren und die beste zu wählen verschiebt Optimierung nur eine Ebene höher. Erfassen Sie Beobachtungszahl, unterschiedliche Marktphasen und tatsächliche Trades je Testintervall. Eine lange Kalenderperiode mit wenigen unabhängigen Entscheidungen kann weniger Belege liefern als ihre Dauer suggeriert.
Informationslecks verstecken sich in der Datenvorbereitung
Chronologische Aufteilung ist notwendig, aber nicht ausreichend. Wer ein Merkmal mit dem Mittelwert der gesamten Stichprobe standardisiert, lässt künftige Beobachtungen frühere Eingaben beeinflussen. Die Auswahl überlebender Wertpapiere, revidierte Makrodaten oder Berichte vor ihrem Veröffentlichungszeitpunkt erzeugen weitere Rückschaufehler. Passen Sie Transformationen an Trainingsdaten an und bewahren Sie nach Möglichkeit die damalige Verfügbarkeit.
Auch Zielvariablen sind wichtig. Sagt ein Trainingsbeispiel eine Rendite über die nächsten fünf Tage voraus, kann sein Ergebnis den Beginn der Testperiode überschneiden. Entfernen oder trennen Sie Beobachtungen, deren Zielzeitfenster die Grenze überqueren. Software kann eine Lücke zwischen Trainings- und Testindizes einfügen; eine sinnvolle Lücke zu wählen erfordert jedoch Verständnis für Zielhorizonte, Veröffentlichungsverzögerungen und Abhängigkeiten im jeweiligen Datensatz.
Trennen Sie das Datum der Eingangsvariablen vom Zeitpunkt, zu dem das vorherzusagende Ergebnis bekannt wird. Ein Montagssignal kann ausschließlich Montagsinformationen verwenden, während seine Fünftagesrendite am Dienstag noch unbekannt ist. Ein Dienstags-Refit darf diese bereits vollständig berechnete Zielvariable nicht verwenden. Die Zulassungsregel muss daher das gesamte Ergebnisintervall und dessen Verfügbarkeit prüfen, nicht nur das erste Datum einer Datenzeile.
Innerhalb des Trainings optimieren, eine unangetastete Auswertung bewahren
Parameter sollten ausschließlich anhand von Informationen im Trainingsbereich ausgewählt werden, gegebenenfalls durch ein inneres chronologisches Validierungsverfahren. Das äußere Testintervall bewertet anschließend das ausgewählte Verfahren. Diese Verschachtelung unterscheidet Modellauswahl von der Messung ihrer Leistung. Sie erhöht auch den Rechenaufwand, was einem billigen, aber verunreinigten Ergebnis vorzuziehen ist.
Aggregieren Sie aufeinanderfolgende Testrenditen in tatsächlicher Zeitreihenfolge, einschließlich Perioden ohne Position. Wenden Sie Gebühren und Ausführungsannahmen konsistent an. Mitteln Sie attraktive Kennzahlen einzelner Testabschnitte nicht ohne wirtschaftliche Prüfung: Sonst erhält ein kleiner ruhiger Abschnitt scheinbar dieselbe Bedeutung wie ein langer volatiler. Zeigen Sie Streuung zwischen Intervallen neben dem Gesamtergebnis.
Ein schwaches Ergebnis ist ein nutzbarer Befund
Walk-forward-Leistung, die nach Kosten abfällt, von einem Intervall abhängt oder auf kleine Timingänderungen dramatisch reagiert, verdient Untersuchung statt kosmetischer Reparatur. Trennen Sie Daten- oder Umsetzungsfehler von einer schlicht unbelegten Strategie. Ein echter behobener Fehler kann einen neuen Lauf rechtfertigen, aber die vorherige Kenntnis der Ergebnisse bleibt Teil der Analysehistorie.
Schließen Sie bei weiterem Prüfbedarf mit eingefrorener Spezifikation und einer wirklich neuen Papierbeobachtungsperiode. Legen Sie Datenerhebung und Widerlegungsbedingungen vorab fest. Ziel ist nicht endlose Optimierung bis zu einer attraktiven Linie, sondern festzustellen, ob ein diszipliniertes, umsetzbares Verfahren Gelegenheiten zum Scheitern übersteht.
Das Portfolio über Testgrenzen hinweg fortführen
Ein Modell-Refit bedeutet nicht automatisch eine Liquidation. Endet ein Test von Januar bis März mit einer Position, deren ursprünglicher Ausstieg im April liegt, muss feststehen, ob die alte Regel gilt, eine dokumentierte neue Regel übernimmt oder die Position gegen Kosten geschlossen wird. Jedes Fenster ohne verbuchte Schließung auf Cash zurückzusetzen kann Verluste entfernen, Kapital erfinden oder schwierige Übergänge umgehen. Der Prozess benötigt Regeln für vorhandene Positionen ebenso wie für neue Signale.
Auch das Kapital muss fortgeführt werden. Ein Testgewinn von 10 % und ein nachfolgender Verlust von 10 % ergeben 1,10 × 0,90 = 0,99 und damit 1 % Gesamtverlust. Der Durchschnitt von null bildet das Konto nicht nach. Bewahren Sie die zeitliche Renditereihe unter einheitlichen Größen- und Finanzierungsregeln und berechnen Sie die Gesamtkennzahlen daraus. Überschneiden sich Testfenster, darf dieselbe Kontorendite nicht doppelt zählen: Legen Sie fest, welches Modell entscheidet oder wie mehrere Modelle Kapital teilen.
Die Auswahl gehört in den jeweiligen Trainingszeitraum, einschließlich Variablenauswahl, Skalierung und Ergänzung fehlender Werte. Eine einmal über sämtliche Daten angepasste Transformation bleibt verunreinigt, auch wenn das Endmodell sauber neu trainiert wird. TimeSeriesSplit liefert chronologische Aufteilungen und einen optionalen Indexabstand. Das Verfahren kennt aber weder die Reife einer finanziellen Zielvariable noch spätere Datenrevisionen oder den Umgang mit offenen Positionen. Dafür ist das Forschungsdesign verantwortlich.
Führen Sie je Fenster ein Protokoll mit Trainingsende, zulässigen Beobachtungen, gewählter Spezifikation, erster möglicher Ausführung, Anfangspositionen, Kosten und Endpositionen. Begründen Sie auch ausgelassene Daten und Orders. So lässt sich ein Leistungseinbruch einem geschwächten Mechanismus, veränderter Stichprobe oder Grenzfehler zuordnen. Nach einer Bugkorrektur wird die gesamte Regel konsistent neu gerechnet; das frühere Ergebnis bleibt dokumentiert, statt den neuen Lauf als unberührtes Experiment darzustellen.