Validation walk-forward : exclure demain de l’entraînement
Concevez un processus de recherche chronologique qui évalue toute la procédure de décision plutôt qu’une règle historique optimisée.
Tester un processus plutôt qu’une formule finale
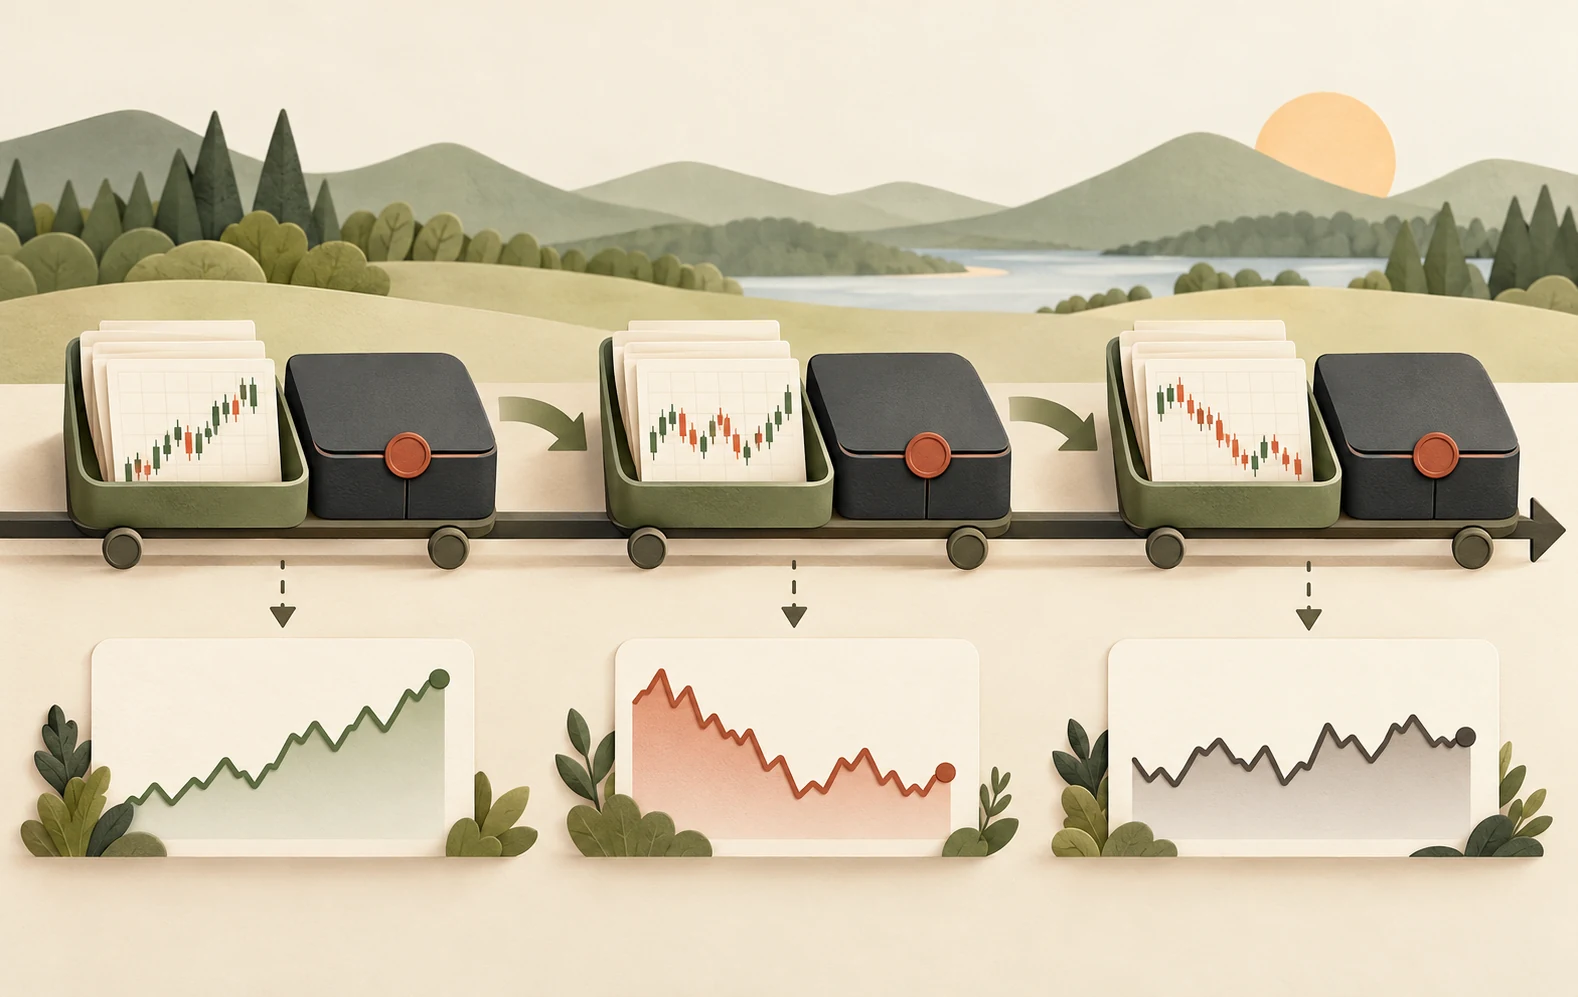
Une étude walk-forward ajuste à répétition un modèle avec l’information disponible à une date historique, fige les décisions obtenues et les évalue sur une période ultérieure, puis avance. Cela imite une recherche sans connaissance future. Cela ne rend pas une stratégie rentable et n’élimine pas tous les biais.
Notez ce qui peut changer à chaque étape. Les paramètres des signaux, la sélection des actifs, les estimations de volatilité et les hypothèses de coûts font tous partie de la procédure. Si le chercheur les ajuste manuellement après avoir vu une période de test, la procédure a changé et cette période n'est plus une évaluation indépendante. Un calendrier reproductible est plus instructif qu'un graphique assemblé à partir de révisions discrétionnaires.
Choisir délibérément un historique glissant ou croissant
Une fenêtre croissante conserve toutes les observations antérieures à mesure que le temps avance. Elle peut stabiliser les estimations, mais aussi garder des données de conditions obsolètes. Une fenêtre glissante utilise une période récente de longueur fixe, facilitant l’adaptation tout en augmentant le bruit d’échantillonnage. Aucune méthode n’est toujours supérieure ; l’arbitrage dépend de la relation économique supposée durable.
Choisissez les longueurs de fenêtre pour une raison défendable avant de comparer les résultats. Essayer des dizaines de durées et retenir la meilleure ne fait que déplacer l'optimisation à un niveau supérieur. Consignez le nombre d'observations, les épisodes de marché distincts et les opérations effectives dans chaque intervalle de test. Une longue période calendaire comportant très peu de décisions indépendantes peut fournir moins de preuves que sa durée ne le suggère.
Les fuites se cachent dans la préparation des données
Une séparation chronologique est nécessaire, mais insuffisante. Standardiser une variable avec la moyenne complète laisse le futur influencer le passé. Sélectionner les titres survivants, utiliser des données macroéconomiques révisées ou un document avant publication crée d’autres biais rétrospectifs. Ajustez les transformations sur l’entraînement et préservez si possible la disponibilité réelle à chaque date.
Les étiquettes comptent également. Si un exemple d'entraînement prédit un rendement mesuré sur les cinq jours suivants, son résultat peut chevaucher le début de la période de test. Retirez ou séparez les observations dont les fenêtres d'étiquetage franchissent cette frontière. Un logiciel peut insérer un intervalle entre les indices d'entraînement et de test, mais choisir un intervalle pertinent exige de comprendre les horizons des étiquettes, les délais de publication et les dépendances propres aux données.
Distinguez la date des variables de celle à laquelle le résultat à prédire devient connu. Un signal formé lundi peut utiliser uniquement les données disponibles lundi, alors que son rendement futur sur cinq jours reste inconnu mardi. Un réentraînement mardi ne peut pas employer cette étiquette déjà complète. La règle d’admissibilité doit vérifier tout l’intervalle du résultat et sa disponibilité, pas seulement que le premier horodatage de la ligne précède la coupure.
Ajuster sur l’entraînement, préserver une évaluation intacte
La sélection des paramètres doit utiliser uniquement les informations de la zone d’entraînement, éventuellement via une validation chronologique interne. L’intervalle de test externe évalue ensuite la procédure sélectionnée. Cette imbrication distingue le choix d’un modèle de la mesure de ses performances. Elle augmente aussi le coût de calcul, ce qui vaut mieux qu’un résultat peu coûteux mais contaminé.
Agrégez les rendements de test séquentiels dans leur ordre chronologique réel, y compris les périodes sans position. Appliquez frais et hypothèses d’exécution de façon cohérente. Ne moyennez pas des ratios séduisants par sous-période sans examiner leur sens économique : un court intervalle calme pourrait peser autant qu’un long intervalle volatil. Montrez la dispersion entre intervalles avec le résultat combiné.
Un résultat faible est une preuve exploitable
Une performance en validation progressive qui se détériore après coûts, dépend d'un seul intervalle ou change radicalement après un léger ajustement temporel mérite une investigation plutôt qu'une retouche cosmétique. Distinguez un défaut de données ou de mise en œuvre d'une stratégie simplement insuffisamment étayée. Corriger un véritable bogue peut justifier une nouvelle exécution, mais l'exposition antérieure aux résultats doit rester dans l'historique de recherche.
Terminez par une spécification figée et une période réellement nouvelle d’observation sur papier si une évaluation supplémentaire se justifie. Définissez à l’avance les données à collecter et ce qui invaliderait les hypothèses. Le but n’est pas d’optimiser jusqu’à obtenir une jolie courbe, mais de déterminer si une procédure rigoureuse et applicable résiste aux occasions d’échouer.
Conserver la continuité du portefeuille entre fenêtres de test
Réentraîner un modèle n’impose pas automatiquement de liquider le portefeuille. Si la fenêtre janvier-mars se termine avec une position dont la sortie initiale est prévue en avril, décidez si elle conserve cette règle, adopte une nouvelle règle documentée ou est clôturée avec ses coûts. Remettre chaque fenêtre à zéro en cash sans comptabiliser cette clôture peut effacer des pertes, inventer du capital disponible ou éviter une transition difficile. Il faut une politique pour les positions existantes autant que pour les nouvelles prévisions.
Le capital doit lui aussi se transmettre. Un gain de 10 % suivi d’une perte de 10 % multiplie la richesse par 1,10 × 0,90 = 0,99, soit une perte nette de 1 %. La moyenne nulle des deux pourcentages ne reconstitue pas le compte. Conservez la série chronologique sous des règles cohérentes de financement et de taille, puis calculez les indicateurs agrégés. Si des fenêtres se chevauchent, ne comptez pas deux fois le même rendement : précisez quel modèle pilote chaque décision ou comment le capital est partagé.
La sélection appartient à chaque période d’entraînement, y compris choix des variables, normalisation et traitement des valeurs manquantes. Une transformation ajustée sur toute la série reste contaminée même si l’estimateur final est honnêtement réentraîné. TimeSeriesSplit fournit des séparations chronologiques et un écart optionnel entre indices ; il ne connaît ni la maturation d’une étiquette financière, ni les révisions de publications, ni la gestion d’une position ouverte. Ces choix relèvent du protocole de recherche.
Tenez un registre par fenêtre : date de coupure, observations admissibles, spécification retenue, première exécution possible, positions initiales, coûts et positions finales. Justifiez aussi chaque observation ou ordre omis. Vous pourrez ainsi distinguer mécanisme affaibli, changement d’échantillon et erreur de frontière. Après correction d’un bug, reprenez la procédure de façon cohérente et conservez l’ancien résultat dans l’historique, au lieu de présenter la nouvelle exécution comme une expérience jamais observée.